


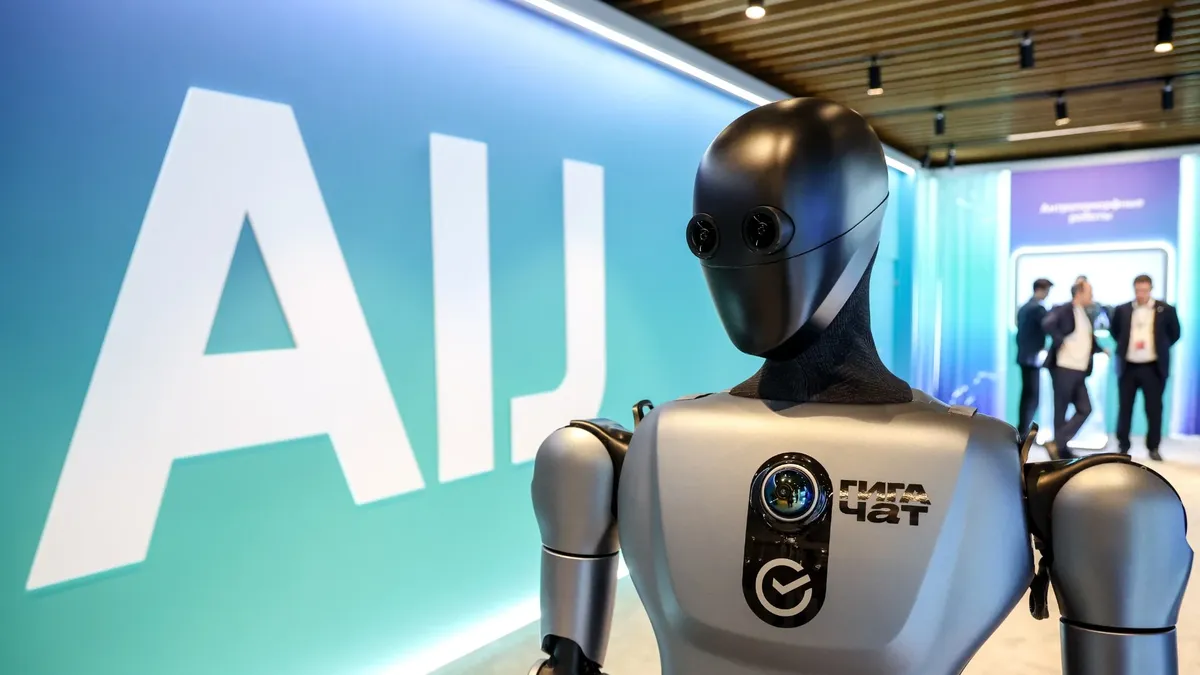
В правительстве идет обсуждение законов, обязывающих бизнес использовать суверенные модели искусственного интеллекта. Пока это лишь дискуссии и коллекции предложений, однако даже к этой стадии участники рынка относятся скептически. Кто-то говорит про финансовые причины, кто-то — про ограничение конкуренции, но главная проблема, как всегда, не в этом.
Важное лирическое отступление. Все переживают ИИ-психоз. Новости про то, как нейросети захватят мир и уничтожат человечество, — на первых полосах мировых СМИ. Большие языковые модели со всеми производными — главный хит сезона. Истории про то, кто и как использует условный ChatGPT, вытеснили застольные разговоры о политике.
Но у нас, согласно традициям, всё приобретает, мягко говоря, шизофреническую форму. Даже тем, кто более или менее разбирается в теме, придется напрячь мозг, чтобы осознать масштабы происходящего.
Для начала предлагаются два термина: суверенная и национальная модель.
«Суверенная модель ИИ должна быть разработана на всех этапах только российским юрлицом и работать только на инфраструктуре в РФ. Под определение суверенной модели в РФ подпадает только GigaChat от «Сбера». Национальная — должна быть существенно разработана российским юрлицом, но ее компоненты могут включать решения с открытым исходным кодом — например, Alice AI».
Но мы пропустим этап обсуждения этой странной формулировки и перейдем к практике.
Когда речь идет о государстве в виде многочисленных ведомств — вопросов нет. Небольшим и небогатым странам выгодней заключать прямые договоры с мировыми лидерами. Но в случае России это было бы странно. И дело даже не в безопасности или традиционных ценностях: РФ смело может гордиться несколькими моделями, которые способны решить большинство насущных проблем.
В случае бизнеса всё сложнее. Выбор ИИ может быть обусловлен множеством факторов. Для начала — это цена. Любой вопрос стоит денег, токены и вычислительные мощности на дороге не валяются. И даже формулировка «Компании и организации должны будут выбирать суверенную модель ИИ, если она не дороже национальной больше чем в полтора раза» кажется спорной. Отбросим терминологию: вероятно, какой-нибудь китайский DeepSeek может оказаться самым оптимальным решением, но оно автоматически окажется вне закона.
Кажется, что среднему предпринимателю плевать на эти тонкости. Выбор решения находится за национальными пределами.
Большие модели, созданные чтобы решать универсальные задачи, могут оказаться бессмысленными или неэффективными в каких-то специфических случаях. Разбираться, что там суверенное и национальное, — слишком сложно.
Стоит уточнить: пока это всё предложения от участников рабочих групп, поток сознания от разных интересантов. Одним нужны инновации, другие защищают страну. О каких-то законах говорить пока рано. Так что, следуя традиции брейнсторма, обсуждаем, но не критикуем.
Главная претензия к происходящему: государство опять хочет залезть в частную жизнь, и в случае бизнеса это может оказаться критичным, причем не только для тех, кто планирует использовать те или иные модели, но и для разработчиков оных.

Фото: Агентство «Москва»
Уже на стадии формулировки возникает конфликт. Сегодня у нас есть два лидера — «Сбер» со своей коллекцией моделей, знакомый массовому пользователю по сервису Kandinsky, и «Яндекс» с «Алисой». Оба продукта имеют разную историю разработок. В результате один — суверенный, другой — национальный. Теоретически и то, и то звучит комплиментарно, но, кажется, в результате обидно всем, тем более что список местных достижений длиннее.
У нас есть нейросети от Т-Банка, а если точнее — его подразделения Т-Технологии. Модели T-Lite и T-Pro — популярные корпоративные решения. Есть большое решение от МТС — MWS AI Agents Platform, включающее семейство моделей Cotype. Отдельно любопытно, что описание платформы сопровождается комментарием, что компоненты продукта включены в реестр российского ПО, а сама платформа — нет. Есть DeepPavlov, созданный при поддержке МФТИ. Свои модели есть даже у печально популярного Wildberries, но про BerryLLM известно так же мало, как и про саму компанию.
Внутренности всех этих разработок имеют разное происхождение. Где-то — самостоятельно написанный софт, в каких-то случаях всё построено на доступных моделях с открытым кодом (к примеру, A-Vibe от «Авито» построен на базе китайского Qwen). Это логично и объяснимо: желающие запрыгнуть в локомотив ИИ-гонки используют для этого все доступные возможности. На Клондайке правил нет, а скандалы о том, как участники рынка воруют данные и технологии друг у друга, — привычный фон.
Сегодня любая попытка жесткого регулирования неизбежно приведет к конфликту, даже среди своих. Доказательство патриотизма может оказаться дорогим или просто невозможным: черт его знает, из чего слеплен VoiceKit от VK.
Поддержите
нашу работу!
Нажимая кнопку «Стать соучастником»,
я принимаю условия и подтверждаю свое гражданство РФ
Если у вас есть вопросы, пишите [email protected] или звоните:
+7 (929) 612-03-68
Но эта штука работает. А если начать копаться, может всплыть масса подробностей, которые никак не клеятся с традиционными ценностями.
Национальное, суверенное, включенное в тот или иной реестр или нет, — маркеры творящегося бардака и возможных последствий регуляторики можно перечислять долго, как и в случае предложений рабочей группы в правительстве, это вопрос фантазии. Но любой торт, даже состоящий из безумных идей, требует вишенки, которая покажет: всё еще сложнее.
Сегодня есть группа мировых лидеров в области ИИ: OpenAI со своим ChatGPT, который, кажется, стал синонимом словосочетания «искусственный интеллект», Google с линейкой моделей Gemini. Есть Anthropic со своим Claude, который наравне с коллегами сражается за бюджеты Пентагона. Есть Европа, представленная французским Mistral, известным массовой публике по сервису Le Chat, есть Китай — и тут даже можно не перечислять названия. И, конечно, Россия: GigaChat от «Сбера» — полноценный участник глобальной гонки.
Но в следующем году всё может поменяться. Появятся новые игроки, новые технологии, новые компании. Если сейчас кажется, что без доступа к вычислительным мощностям, подразумевающим миллиардные инвестиции, невозможно выйти на рынок, то завтра может выясниться, что главный хит — это небольшие модели, которые работают на устройстве пользователя. Или вдруг окажется, что инференс, то есть генерация ответа, не требует дорогих ресурсов. Да в конце концов, сегодня искусственный интеллект в прямом смысле сам себя разрабатывает. Прогнозировать, до чего он додумается в ближайшее время, — дело неблагодарное.
В конце концов, может, не мы будем регулировать искусственный интеллект, а он нас.

Поддержите
нашу работу!
Нажимая кнопку «Стать соучастником»,
я принимаю условия и подтверждаю свое гражданство РФ
Если у вас есть вопросы, пишите [email protected] или звоните:
+7 (929) 612-03-68


